React로 상태 관리를 하거나, 라우터 히스토리를 다룰 때 우리는 이미 매일 자료구조를 쓰고 있다.
하지만 어떤 자료구조로 쓰고 있는지 메모리의 동작 원리까지 제대로 알고 있어야 잘 다룰 수 있지 않을까?!
그래서 이번 글에서는 Array 와 Linked List를 같이 다뤄볼 예정이다.
1. Array - 연속된 메모리
배열은 메모리 상에 연속된 공간을 미리 잡아두는 구조이다.
각 요소는 동일한 크기의 공간을 차지하기 때문에, 첫번째 요소의 주소만 알면 n번째 요소의 주소를 덧셈 한 번으로 바로 계산할 수 있다.
인덱스 = 시작 주소 + (인덱스 x 타입크기) 라는 수식으로 계산할 수 있다.
예를 들어 아파트로 비유를 들어보자!
배열을 번호가 붙은 아파트 동이라고 상상해보자. 101호, 102호, 103호, 104호... 가 연속으로 붙어있을때
각 호실의 크기는 모두 동일 (예: 4byte) 하고 입구(시작 주소)만 알면 몇 호든 바로 찾아갈 수 있다.
만약 시작 주소가 100 이고 각 요소가 4byte 라면, 컴퓨터는 arr[2]는 100 + (2 x 4) = 108 즉 108 이라는 주소에 있다는 것을 순서대로 찾지 않아도 즉시 알 수 있다. 그래서 배열의 인덱스 접근이 O(1)인 이유이다.
시작주소: 0x100 (101호 입구)

101호 → 0x100
102호 → 0x100 + (1 × 4) = 0x104
103호 → 0x100 + (2 × 4) = 0x108  ← arr[2] 접근
104호 → 0x100 + (3 × 4) = 0x10C
JavaScript에서의 Array
JS의 배열은 다른 언어의 배열과 조금 다르다. C나 Java 같은 언어에서는 배열을 선언할 때 크기와 타입을 고정해야 하지만,
JS의 배열은 크기도 타입도 자유롭다. 숫자, 문자열, 객체를 한 배열에 섞어 넣을 수도 있고, 선언 이후에 크기를 늘리거나 줄일 수도 있다.
이게 가능한 이유는 JS의 배열이 내부적으로 동적 배열로 구현되어 있기 때문이다.
const arr = [10, 20, 30];

// O(1) — 인덱스 접근 (메모리 주소 계산)
arr[1]; // 20

// O(1) amortized — 끝에 추가 (공간 있으면 그냥 추가)
arr.push(40);

// O(n) — 앞에 추가 (전체 요소를 한 칸씩 뒤로 밀기)
arr.unshift(0);

// O(n) — 중간 삽입/삭제 (이후 요소 전부 이동)
arr.splice(1, 0, 99);
(1) push
배열의 맨 뒤에 추가하는 거라 아무 요소도 움직이지 않는다.
그리고 동적 배열은 처음에 일정 용량을 잡아두고, 요소를 추가하다가 용량이 꽉 차면 더 큰 메모리를 새로 할당한 뒤 기존 데이터를 통째로 복사한다. 이 복사 비용이 있긴 하지만 자주 발생하지 않기 때문에 push()의 시간복잡도를 평균적으로 O(1)이라고 표현하고, 이를 amortized O(1)이라 부른다.
(2) unshift
맨 앞에 추가하는 거라 기존 요소가 한칸씩 뒤로 밀려야 한다. 요소가 n개면 최대 n번 이동이 발생하기 때문에 시간복잡도는 O(n)이다.
(3) splice
중간에 삽입하거나 삭제하면 그 뒤에 있는 요소들이 전부 한칸씩 밀리거나 당겨와야 한다.
최악의 경우 맨앞을 건드리면 n번 이동이 발생하기 때문에 시간복잡도는 O(n)이다.
2. Linked List - 포인터로 연결된 체인
연결 리스트는 노드(Node)들이 포인터로 연결된 구조이다. 각 노드는 data와 다음 노드의 주소인 next를 가진다.
메모리가 흩어져 있어도 된다.
메모리 구조
Linked List는 배열과 달리 메모리에 연속으로 붙어있을 필요가 없다.
그렇기 때문에 메모리 어디에 흩어져 있어도 포인터를 따라가면 전체를 순회할 수 있다.
위 코드를 보면 0x200에 있는 첫 번째 노드가 data로 10을 가지고, next로 다음 노드의 주소인 0x450을 가리키고 있다. 0x450에 있는 두 번째 노드는 data로 20을 가지고, next로 0x1A0을 가리킨다. 마지막 노드는 더 이상 가리킬 노드가 없으니 next가 null이다.
// 메모리 어디든 상관없이 흩어져 있음
0x200  { data: 10, next: 0x450 }  // head
0x450  { data: 20, next: 0x1A0 }
0x1A0  { data: 30, next: null }   // tail

// index 2 접근: head → next → next → O(n)
이 구조의 특징은 삽입과 삭제가 빠르다는 점이다.
배열은 중간에 요소를 추가하면 뒤에 있는 요소를 전부 밀어야 하지만, Linked List는 포인터만 바꿔주면 된다.
예를 들어 10과 20 사이에 새 노드를 끼워넣고 싶다면, 첫 번째 노드의 next를 새 노드로 바꾸고 새 노드의 next를 20을 가리키게만 하면 끝이다. 나머지 노드들은 건드릴 필요가 없다.
반대로 단점은 인덱스로 바로 접근할 수 없다는 점이다. arr[2] 처럼 위치를 계산할 수 없으니, n번째 노드를 찾으려면 항상 head부터 next를 따라 하나씩 순회해야 한다. 그래서 인덱스 접근의 시간 복잡도가 O(n)인 것이다.
그리고 배열은 값만 저장하면 되지만 Linked List는 각 노드마다 값과 함께 다음 노드의 주소를 가르키는 포인터를
항상 같이 저장해야 한다. 노드가 늘어날수록 포인터도 같이 늘어나기 때문에 배열에 비해 메모리를 더 사용하게 된다.
데이터가 적을 때는 큰 차이가 없지만, 노드가 많이질 수록 이 차이가 커지기 때문에 메모리가 제한된 환경에서는 무시할 수 없는 단점이다.
JavaScript에서의 Linked List
class Node {
  constructor(data) {
    this.data = data;  // 실제 값 (예: 10, 20, 30)
    this.next = null;  // 다음 노드를 가리키는 포인터, 처음엔 연결 없음
  }
}

class LinkedList {
  constructor() {
    this.head = null;  // 첫 번째 노드. 이걸 시작점으로 순회함
    this.size = 0;
  }

  // 맨 앞에 추가 — O(1)
  // 새 노드가 기존 head를 가리키고, head를 새 노드로 교체
  prepend(data) {
    const newNode = new Node(data);
    newNode.next = this.head;  // 새 노드 → 기존 첫 번째 노드
    this.head = newNode;       // 이제 새 노드가 첫 번째
    this.size++;
  }

  // 맨 뒤에 추가 — O(n)
  // 마지막 노드를 모르니까 head부터 끝까지 직접 걸어가야 함
  append(data) {
    const newNode = new Node(data);

    // 리스트가 비어있으면 새 노드가 바로 head
    if (!this.head) {
      this.head = newNode;
      return;
    }

    // next가 null인 노드 = 마지막 노드, 찾을 때까지 순회
    let current = this.head;
    while (current.next) {
      current = current.next;
    }

    current.next = newNode;  // 마지막 노드가 새 노드를 가리키게
    this.size++;
  }

  // 특정 노드 바로 뒤에 추가 — O(1)
  // 삽입할 위치(prevNode)를 이미 알고 있을 때만 O(1)
  insertAfter(prevNode, data) {
    const newNode = new Node(data);
    newNode.next = prevNode.next;  // 새 노드 → 기존 다음 노드
    prevNode.next = newNode;       // prevNode → 새 노드
  }
}
Node 클래스는 Linked List의 가장 기본 단위다.
data는 실제 값을 담고, next는 다음 노드를 가리키는 포인터 역할을 한다.
처음 생성할 때는 연결된 노드가 없으니 next를 null로 초기화한다.
LinkedList 클래스는 head와 size를 가진다.
head는 첫 번째 노드를 가리키고, 이 head만 알면 next를 따라가며 전체 리스트를 순회할 수 있다.
size는 현재 노드의 개수를 추적한다.
(1) prepend는 맨 앞에 추가하는 메서드다.
새 노드의 next를 기존 head로 연결하고, head를 새 노드로 바꿔치기하면 끝이다.
포인터 두 개만 변경하면 되니까 리스트의 크기와 상관없이 항상 O(1)이다.
(2) append는 맨 뒤에 추가하는 메서드다.
Linked List는 인덱스로 위치를 계산할 수 없기 때문에 마지막 노드를 찾으려면 head부터 next가 null인 노드까지 하나씩 순회해야 한다. 그래서 노드가 n개면 n번 순회하니까 O(n)이다.
(3) insertAfter는 특정 노드 뒤에 삽입하는 메서드다.
새 노드의 next를 prevNode의 다음 노드로 연결하고, prevNode의 next를 새 노드로 바꿔주면 된다.
이미 삽입할 위치의 노드를 알고 있다는 전제이기 때문에 순회가 필요 없고 포인터만 변경하면 되니까 O(1)이다. 배열에서 중간 삽입이 O(n)인 것과 대비되는 Linked List의 핵심 강점이다.
캐시 효율성 비교
Array는 캐시효율이 좋다는 장점이 있다.
Cpu는 메모리에 데이터를 읽을때 해당 데이터 하나만 읽지 않고, 그 주변 데이터까지 한꺼번에 캐시에 올려놓는다.
어차피 근처 데이터도 곧 쓸 가능성이 높다고 판단하기 때문이다. 이를 캐시 지역성 이라고 한다.
배열은 요소들이 메모리에 나란히 붙어 있으니, arr[0]을 읽을 때 arr[1], arr[2], arr[3]도 이미 캐시에 올라와 있다.
그래서 다음 요소를 읽을 때 메모리까지 다시 갔다 올 필요 없이 캐시에서 바로 꺼내쓸 수 있다.
때문에 배열은 순서대로 순회할 때 캐시를 최대한 활용할 수 있어서 실제 체감 속도가 빠르다.
하지만 Linked List는 반대이다. 노드들이 메모리 여기저기에 흩어져 있으니, 다음 노드를 읽으러 갈 때마다 캐시에 없는 경우가 많다.
그때 마다 메모리까지 다시 갔다 와야하는데, 캐시에서 읽는 것보다 메모리에서 읽는게 수십배 느리다.
때문에 이론적인 시간 복잡도는 비슷할지 몰라도 캐시 미스가 자주 발생해 실제로는 더 느린 경우가 많다.
시간복잡도 비교
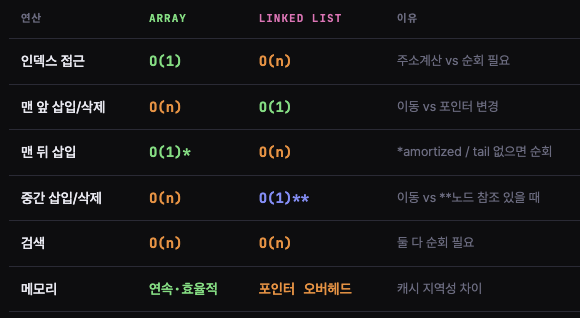
Array 선택 기준
- 인덱스로 자주 접근할 때
- 데이터 크기가 예측 가능할 때
- 끝에만 추가/삭제할 때
- 캐시 성능이 중요할때
Linked List 선택 기준
- 앞쪽 삽입/삭제가 빈번할 때
- 크기가 자주 바뀌는 경우
- 중간 삽입이 많고 노드 참조 가능할 때
프론트엔드 실전 예시
1. Array - React 상태 리스트 관리
React의 useState로 관리하는 Todo 리스트는 전형적인 Array 사용 패턴이다.
중간 삽입보다 순회 렌더링이 많기 때문이다.
const [todos, setTodos] = useState([]);

// push → O(1) amortized
const addTodo = (text) =>
  setTodos(prev => [...prev, { id: Date.now(), text }]);

// filter → O(n): 완료 항목 제거
const remove = (id) =>
  setTodos(prev => prev.filter(t => t.id !== id));

// map → O(n): 전체 렌더링 (Array가 적합한 이유)
return todos.map(t => <TodoItem key={t.id} {...t} />);
2. Linked List - 브라우저 히스토리 / Undo 기능
뒤로가기/앞으로 가기, Undo/Redo는 Linked List의 대표적인 활용이다. 앞에 추가하고 앞에서 꺼내는 패턴이 O(1)이기 때문이다.
class HistoryManager {
  constructor() {
    this.stack = null; // Linked List (head = 최신)
  }

  // O(1) — 새 액션 저장 (head에 추가)
  push(action) {
    this.stack = { data: action, next: this.stack };
  }

  // O(1) — Undo (head 제거)
  undo() {
    if (!this.stack) return null;
    const action = this.stack.data;
    this.stack = this.stack.next;
    return action;
  }
}

// 사용 예
const history = new HistoryManager();
history.push({ type: 'INPUT', value: 'Hello' });
history.push({ type: 'STYLE', value: 'bold' });
history.undo(); // { type: 'STYLE', value: 'bold' }
3. Linked List - 무한 캐러셀
무한 캐러셀은 Circular Linked List(원형 링크드 리스트)의 대표적인 활용 예시다.
일반 Linked List는 마지막 노드의 next가 null이지만, Circular Linked List는 마지막 노드의 next가 다시 첫 번째 노드를 가리킨다.
이 구조 덕분에 끝에 도달해도 자연스럽게 처음으로 돌아오는 순환이 만들어진다.
class CircularCarousel {
  constructor(items) {
    this.nodes = items.map(i => ({ data: i, next: null }));
    // 마지막 노드 → 첫 노드 연결 (원형)
    this.nodes.forEach((n, i) => {
      n.next = this.nodes[(i + 1) % this.nodes.length];
    });
    this.current = this.nodes[0];
  }

  next() { this.current = this.current.next; } // O(1)
  get()  { return this.current.data; }
}
마무리
Array와 Linked List는 둘 다 데이터를 순서대로 저장하는 자료구조 이지만 동작 방식이 완전히 다르다.
Array는 메모리에 연속적으로 붙어있기 때문에 인덱스로 바로 접근할 수 있고 캐시 효율도 좋지만,
앞이나 중간을 건드리면 나머지 요소를 전부 밀거나 당겨야 한다.
Linked List는 포인터로 노드를 연결하는 구조라 메모리가 흩어져 있어도 되고 앞쪽 삽입과 삭제가 빠르지만
인덱스로 바로 접근할 수 없고 노드마다 포인터를 저장해야 해서 메모리를 더 사용하게 된다.
결국 두 자료구조는 서로 반대되는 장단점을 가지고 있다.
Array는 읽기에 강하고 Linked List는 삽입과 삭제에 강하다.
어떤 자료구조가 더 좋다고 할 수 없고, 데이터에 얼마나 자주 접근하는지, 삽입과 삭제가 얼마나 빈번한지,
메모리를 얼마나 효율적으로 써야하는지에 따라 상황에 맞는 선택을 하는 것이 중요하다.
참고
동적 배열을 사용하는 자바스크립트에서 일어나는 일
최근 오픈소스에 기여를 하게 되었는데요. 그동안 번역 혹은 오역의 수정만 했지만 이번에는 코드를 수정한 것이 오픈소스 라이브러리에 반영되었습니다. 버그를 수정한 것은 아니고 성능을 향
curt-poem.tistory.com
'공부 > 자료구조' 카테고리의 다른 글
| (4) Tree (1) | 2026.03.05 |
|---|---|
| (3) Stack, Queue (1) | 2026.03.02 |
| (1) 자료 구조란? (0) | 2026.02.26 |
| [자료구조] Stack (스택) 알아보기 (0) | 2025.10.22 |
| [자료구조] Hash Table (해시 테이블) 알아보기 (0) | 2025.10.22 |