Tree 관련 포스팅을 업로드하기 이전에 Hash table 관련 내용을 올리려고 했는데
이전에 올려뒀던 포스팅이 있어 넘어가고 이번엔 Tree로 진행해보려고 한다.
https://dev-jiwonpark.tistory.com/36
[자료구조] Hash Table (해시 테이블) 알아보기
이미지 최적화 공부를 하다가 문득 ‘데이터를 효율적으로 저장하고 꺼내는 방법’이 얼마나 중요한지 깨달았다.특히, 브라우저 캐시나 CDN이 내부적으로 어떻게 이미지를 빠르게 찾아내는지를
dev-jiwonpark.tistory.com
Tree라는 자료구조를 생각했을때 바로 떠오르는건 DOM 그리고 라우팅 구조였다. 생각해보면 프론트엔드 개발자가 매일 다루는 것들이 사실 전부 트리 구조 위에서 동작하고 있었다.
그래서 이 글에서는 트리에 관하여 정리해보려고 한다.
Tree란?
트리는 계층적인 데이터를 저장하고 효율적으로 탐색하기 위해 설계된 자료구조이다.
그리고 노드(Node) 들이 계층적으로 연결된 비선형 자료구조이다.
배열이나 연결리스트처럼 데이터가 일렬로 나열되는 게 아니라, 부모-자식 관계를 통해 위아래로 뻗어나가는 구조다.
참고로 트리는 Graph의 한 종류이다. 사이클이 없고 모든 노드가 연결된 Graph를 Tree라고 부른다. Tree보다 더 넓은
개념인 Graph는 다음 글에서 다뤄볼 예정이다.
이와 같이 트리의 성립 조건은 다음과 같다.
(1) 비순환성 : 사이클( 순환 ) 이 없어야 한다.
(2) 연결성 : 모든 노드가 연결되어 있어야 한다.
(3) 계층적 단일성 : 루트 노드를 제외하고 모든 노드는 반드시 하나의 부모 노드에 연결되어야 한다.
(4) 노드가 N개라면 간선(Edge)는 항상 N-1 개 이다.
다음으로 Tree를 볼때 나오는 주요 용어들을 정리해보면 아래와 같다.
- 루트 ( Root ) : 최상단 노드, 부모 노드가 없음.
- 부모 / 자식 ( Parent/Child ) : 연결된 노드 간의 상하 관계
- 형제 ( Sibling ) : 같은 부모를 가진 노드들
- 리프 ( Leaf ) : 자식이 없는 최하단 노드 (단말 노드)
- 차수 ( Degree ) : 각 노드가 가진 자식 노드의 수
- 깊이 ( Depth ) : 루트에서 해당 노드까지의 거리
- 높이 ( Height ) : 트리 전체의 최대 깊이
비유로 이해하기
Tree를 가장 직관적으로 비유할 수 있는것은 회사 조직도다.

CEO가 루트, CTO/CFO는 CEO가 부모인 자식 노드이고, 개발팀/디자인팀/재무팀이 리프라고 할 수있다.
파일 시스템도 마찬가지이다.
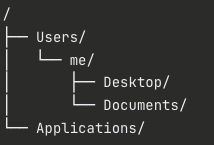
평소에 아무 생각없이 쓰던 폴더 구조도 사실 트리 구조였던 것이다..!
프론트엔드에서의 활용
1. DOM (Document Object Model) 트리
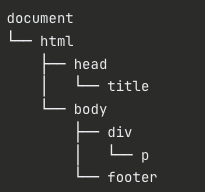
우리가 작성하는 HTML 코드는 브라우저가 이해할수 있도록 트리 구조로 변환된다.
<div>, <ul>, <li> 같은 태그들이 부모-자식 관계를 형성하며 거대한 트리를 이루고
특정 요소를 찾거나(Selector), 스타일을 변경하거나, 새로운 요소를 삽입할 때 이 트리의 노드를 탐색하고 조작한다.
2. Virtual DOM (가상 DOM) - React, Vue 등
실제 브라우저의 DOM을 직접 건드리는 것은 비용이 비싸기 때문에, 메모리상에 가벼운 복사본인 가상 트리를 만든다.
데이터가 변경되면 이전 트리와 새 트리를 비교 (Tree Diffing) 하여, 변경된 부분만 실제 DOM에 반영한다.
이때 재귀적인 트리 탐색 알고리즘이 사용된다.
3. 컴포넌트 계층 구조
프론트엔드 프레임워크는 화면을 독립적인 단위인 " 컴포넌트 " 로 쪼개서 관리한다.
App 컴포넌트(Root) 아래에 Header, Main, Footer가 있고, Main 안에 다시 Card나 Button이 들어가는 식의 계층적 구조이다.
부모 컴포넌트에서 자식 컴포넌트로 데이터를 전달하는 Props Drilling 현상이나 상태 관리의 흐름 자체가 트리 구조를 따라 내려간다.
Tree의 장점과 단점
트리는 계층적인 데이터를 다루는 데 좋은 자료구조이지만, 모든 상황에서 만능은 아니다..
우선 장점으로는
(1) 효율적인 탐색 및 수정: 데이터가 규칙에 따라 정렬된 트리(예: 이진 탐색 트리)에서는 검색, 삽입, 삭제를
이라는 매우 빠른 속도로 처리할 수 있다.
(2) 계층적 구조의 명확성: 데이터 간의 상하 관계나 포함 관계(예: 폴더 구조, 조직도)를 논리적으로 표현하기에 가장 적합한 구조이다.
(3) 유연한 크기 조절: 배열과 달리 포인터를 사용하여 노드를 연결하므로, 메모리가 허용하는 한 동적으로 크기를 확장하기 쉽다.
(4) 빠른 범위 검색: 데이터가 정렬된 상태를 유지하므로, 특정 범위의 값을 찾거나 최솟값/최댓값을 탐색하는 데 유리하다.
그외 단점으로는
(1) 추가적인 메모리 소비: 데이터 값만 저장하는 배열과 달리, 자식 노드를 가리키는 포인터(참조) 정보를 추가로 저장해야 하므로 메모리 오버헤드가 발생한다.
(2) 구조 유지의 복잡성: 트리의 균형이 깨질 경우(한쪽으로 치우칠 경우) 검색 속도가 급격히 느려진다. 이를 방지하기 위해 균형을 맞추는 알고리즘(Self-Balancing)을 구현해야 하는데, 이는 프로그래밍적으로 꽤 복잡하다.
(3) 순차 접근의 어려움: 배열처럼 인덱스를 통해 데이터에 즉시 접근(Random Access)할 수 없다. 원하는 데이터를 찾으려면 반드시 루트 노드부터 타고 내려가야 한다.
트리는 이처럼 강력한 장점을 가졌지만 목적에 따라 어떻게 구성하느냐에 따라 성능 차이가 크게 나타난다.
트리의 종류
트리는 형태와 목적에 따라 분류할 수 있다.
1. 이진 트리의 구조적 분류 - 형태에 따라 분류하기
(1) 이진 트리 (Binary Tree)
모든 노드가 최대 2개의 자식(왼쪽, 오른쪽)만 가지는 가장 기본적인 트리다. 아래 나오는 모든 트리의 베이스가 된다.
	1
       / \
      2   3
     /
    4
(2) 정 이진 트리 (Full Binary Tree)
모든 노드가 자식을 0개 또는 2개만 가지는 트리다. 자식이 1개인 노드는 존재하지 않는다.
	1
       / \
      2   3
     / \
    4   5
노드 2 는 자식이 2개 노드 3/4/5 는 자식이 0개, 자식이 1개인 노드가 없으면 정 이진 트리다.
(3) 포화 이진 트리 (Perfect Binary Tree)
모든 내부 노드가 자식을 2개씩 가지고, 모든 리프 노드가 같은 레벨에 있는 트리다.
말 그대로 빈틈없이 꽉 찬 형태다.
	1
       / \
      2   3
     / \ / \
    4  5 6  7
노드 수는 항상 2^(h+1) - 1개다. 높이가 2면 2^3 - 1 = 7개.
정 이진 트리와 헷갈리기 쉬운데, 정 이진 트리는 "자식이 1개인 노드만 없으면 됨", 포화 이진 트리는 "모든 레벨이 완전히 꽉 차야 함"으로 구분하면 된다.
(4) 완전 이진 트리 (Complete Binary Tree)
마지막 레벨을 제외한 모든 레벨이 꽉 차 있고, 마지막 레벨은 왼쪽부터 순서대로 채워진 트리다. 힙(Heap)의 기반 구조이기도 하다.
	1
       / \
      2   3
     / \ /
    4  5 6
마지막 레벨의 오른쪽이 비어있어도 괜찮다. 단, 왼쪽부터 순서대로 채워져야 한다.
// 완전 이진 트리가 아닌 경우 (왼쪽이 비어있음)
        1
       / \
      2   3
       \ /
        5 6
2. 기능에 따른 분류
(1) 이진 탐색 트리 (BST, Binary Search Tree)
이진 트리에 탐색 규칙을 추가한 트리다.
	5
       / \
      3   7
     / \ / \
2 4 6 8- 왼쪽 자식 < 부모 노드
- 오른쪽 자식 > 부모 노드
이 규칙 덕분에 탐색할 때마다 절반씩 범위가 줄어들어 평균 O(log n) 이 가능하다.
단, 아래처럼 한쪽으로 치우치면 O(n)으로 성능이 떨어진다.
// 편향 트리 (최악의 BST)
1
 \
  2
   \
    3
     \
      4
(2) 균형 트리 (Balanced Tree)
BST의 단점인 편향 문제를 해결하기 위해 나온 트리다. 삽입/삭제할 때마다 자동으로 균형을 맞춰서 항상 O(log n)을 보장한다.
// 삽입 후 자동으로 균형 조정
  삽입 전        삽입 후 (회전 발생)
    3               2
   /               / \
  2               1   3
 /
1
대표적인 구현체로 AVL 트리 (높이 차이가 1 이하로 유지)와 레드-블랙 트리 (Java의 TreeMap, C++의 map에 사용)가 있다.
(3) 힙 (Heap)
최댓값 또는 최솟값을 O(1)로 빠르게 꺼내기 위해 설계된 완전 이진 트리다. 우선순위 큐(Priority Queue)에 사용된다.
// 최소 힙 (Min Heap) — 부모가 항상 자식보다 작음
        1
       / \
      3   2
     / \ / \
    7  5 4  6

// 최대 힙 (Max Heap) — 부모가 항상 자식보다 큼
        9
       / \
      7   8
     / \ / \
    3  5 4  6
BST와 다르게 좌우 순서는 상관없고, 부모-자식 간의 대소 관계만 유지하면 된다.
(4) m원 탐색 트리 (m-way Search Tree)
이진 트리가 자식을 최대 2개 가질 수 있다면, m원 탐색 트리는 자식을 최대 m개까지 가질 수 있도록 확장한 트리다.
// 3원 탐색 트리 예시
       [20, 40]
      /    |    \
  [10]  [30]  [50, 60]
노드 하나에 여러 키값을 저장할 수 있어서, 트리의 높이를 낮게 유지할 수 있다.
(5) B-Tree / B+Tree
자식 노드가 많은 m원 탐색 트리의 일종으로, 데이터베이스와 파일 시스템에서 대량의 데이터를 관리하는 표준 구조이다.
두 트리의 핵심 차이는 데이터를 어디에 저장하느냐다.
- B-Tree : 모든 노드에 데이터를 저장한다
- B+Tree : 데이터는 리프 노드에만 저장하고, 리프 노드끼리 연결 리스트로 이어져 있어 범위 탐색이 훨씬 빠르다
// B-Tree — 모든 노드에 데이터 저장
       [30(data), 70(data)]
      /          |          \
[10(data)]  [50(data)]  [80(data)]

// B+Tree — 리프 노드에만 데이터 저장, 리프끼리 연결
        [30, 70]
       /    |    \
  [10] → [30,50] → [70,80]  (리프끼리 연결)
  data     data      data
(B-Tree와 B+Tree는 내용이 많아 별도 글에서 자세히 다룰 예정이다.)
(6) 트라이 (Trie)
문자열의 각 문자를 노드로 저장하는 트리다. 자동완성, 문자열 검색에 특화되어 있고 탐색 시간이 O(L) (L = 문자열 길이)로, 문자열 길이만큼만 탐색하면 된다.
// "cat", "can", "dog" 을 저장한 트라이
root
├── c
│   └── a
│       ├── t  (cat)
│       └── n  (can)
└── d
    └── o
        └── g  (dog)
검색창에서 "ca"를 입력하면 "cat", "can"을 빠르게 추천해줄 수 있는 게 이 구조 덕분이다.
트리를 처음 공부할 때는 그냥 노드가 연결된 구조 아닌가? 싶었는데, 파고들수록 생각보다 훨씬 넓은 개념이었다.
프론트엔드에서 매일 마주치는 DOM, Virtual DOM, 라우팅 구조가 전부 트리 기반이라는 것도 새삼 다시 와닿았다.
트리의 종류를 공부하면서도 느낀 건, 각각의 트리가 그냥 만들어진 게 아니라는 점이다.
BST는 탐색을 빠르게 하기 위해,
균형 트리는 BST의 편향 문제를 해결하기 위해,
힙은 최댓값/최솟값을 즉시 꺼내기 위해,
B+Tree는 대용량 데이터를 디스크에서 효율적으로 읽기 위해 등장했다.
저마다 해결하려는 문제가 있었고, 그 문제에 맞게 구조가 설계된 것이다.
자료구조를 공부할 때 "이게 왜 이렇게 생겼지?"를 생각하면서 보면 훨씬 오래 기억에 남는 것 같다.
다음 글에서는 트리의 상위 개념인 Graph(그래프) 를 다룰 예정이다. 트리가 Graph의 특수한 형태라는 걸 알고 나면, Graph를 이해하는 게 한결 수월할 것이다.
참고
https://ko.wikipedia.org/wiki/%ED%8A%B8%EB%A6%AC_(%EC%9E%90%EB%A3%8C_%EA%B5%AC%EC%A1%B0)
'공부 > 자료구조' 카테고리의 다른 글
| (5) Graph (0) | 2026.03.09 |
|---|---|
| [자료구조] B-Tree / B+Tree / B * Tree (0) | 2026.03.05 |
| (3) Stack, Queue (1) | 2026.03.02 |
| (2) Array, Linked List (0) | 2026.02.28 |
| (1) 자료 구조란? (0) | 2026.02.26 |