Tree 자료구조를 공부하던 중, BST(Binary Search Tree)에서 파생된 구조들을 보다가 B-Tree 계열까지 흘러왔다.
단순히 "균형 잡힌 트리"라는 설명에서 멈추지 않고, 각 변형이 어떤 한계를 보완하기 위해 등장했는지 제대로 짚고 싶어서 따로 정리해두기로 했다.
https://dev-jiwonpark.tistory.com/54
(4) Tree
Tree 관련 포스팅을 업로드하기 이전에 Hash table 관련 내용을 올리려고 했는데 이전에 올려뒀던 포스팅이 있어 넘어가고 이번엔 Tree로 진행해보려고 한다.https://dev-jiwonpark.tistory.com/36 [자료구조] Ha
dev-jiwonpark.tistory.com
B-Tree란?
BST(Binary Search Tree)는 아래 규칙을 가진 이진 탐색 트리다.
- 왼쪽 자식 < 부모 노드
- 오른쪽 자식 > 부모 노드
이 규칙 때문에 자식이 최대 2개(작다/크다 두 방향)로 제한된다.
m원 탐색 트리 (m-way Search Tree)
m원 탐색 트리는 BST를 "넓게" 확장한 구조다. 노드 하나에 값을 여러 개 저장할 수 있고, 자식도 여러 개 가질 수 있다.
노드에 저장된 값들은 범위를 나누는 구분선 역할을 한다.
	[10 | 20 | 30]
        /    |      |       \
     [<10]  [10~20] [20~30]  [>30]
예를 들어 노드에 데이터가 [10 | 20 | 30] 이 있다면
- 10보다 작으면 → 첫 번째 자식
- 10~20 사이면 → 두 번째 자식
- 20~30 사이면 → 세 번째 자식
- 30보다 크면 → 네 번째 자식이 된다.
즉 값 3개가 경계선 역할을 하면서 공간을 4구역으로 쪼개고, 각 구역마다 자식 노드가 하나씩 붙는 것이다.
그래서 키 k개 → 자식 k+1개가 되는 것이다.
BST에서 [15] 노드가 있으면, 15라는 값 자체가 "15보다 작으면 왼쪽, 크면 오른쪽" 이라는 기준선이 되는데.
m원 탐색 트리도 똑같다. 다만 기준선이 1개가 아니라 여러 개일 뿐이다.
그럼 BST보다 왜 효율적인가?
탐색 속도는 트리의 높이에 비례한다. 높이가 낮을수록 비교 횟수가 줄어든다.
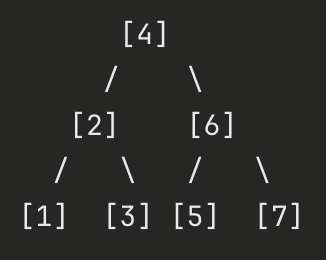
데이터 7개를 기준으로 비교하면
BST
높이: 3
m원 탐색 트리 (노드당 값 3개)
	[2 | 4 | 6]
        /    |    |   \
      [1]   [3]  [5]  [7]
높이: 2
노드 하나에 값을 여러 개 넣으면 트리가 옆으로 넓어지면서 높이가 낮아진다. 데이터가 많아질수록 이 차이는 더 커진다.
다만 m원 탐색 트리는 삽입/삭제 시 균형을 보장하지 않아, 최악의 경우 한쪽으로 치우친 트리가 될 수 있다는 단점이 있다.
예를 들어 1, 2, 3, 4, 5를 순서대로 삽입하면 한쪽으로 치우친 트리가 만들어질 수 있다.
[1]
   \
   [2]
      \
      [3]
         \
         [4]
            \
            [5]
이렇게 되면 트리의 높이가 데이터 수만큼 커지고, 5를 찾으려면 루트부터 5번 내려가야 한다.
결국 탐색 성능이 O(log n)이 아닌 O(n) 으로 떨어져, 트리를 쓰는 의미가 없어진다.
그래서 B-Tree는 이 m원 탐색 트리에 균형 조건을 추가한 자료구조다.
B-Tree 계열은 데이터베이스(DB) 인덱스나 파일 시스템의 근간이 되는 매우 중요한 자료구조이다.
이진 트리와 달리 한 노드에 여러 데이터를 담을 수 있어, 디스크 접근 횟수를 줄이는 데 최적화되어 있다.
B-Tree
B-Tree는 m원 탐색 트리의 불균형 문제를 해결하여 항상 균형을 유지하도록 고안된 자료구조이며
데이터베이스와 파일 시스템의 가장 기본이 되는 구조이다.
핵심 조건
- 모든 리프 노드는 같은 레벨에 존재한다.
- 노드당 최대 m-1개의 키, 최대 m개의 자식을 가진다.
- 루트를 제외한 모든 노드는 최소 ⌈m/2⌉개의 자식을 가져야 한다.
덕분에 탐색/삽입/삭제 모두 항상 O(log n) 을 보장한다.
하지만 모든 노드에 키와 데이터를 함께 저장하기 때문에, 범위 탐색(예: 10~100 사이의 데이터 전부 조회)을 할 때 트리 전체를 순회해야 해서 비효율적이다. 이 문제를 해결한 것이 B+Tree 이다.
B+Tree
B-Tree의 범위 탐색 문제를 해결하기 위해 고안됐다.
B-Tree와의 차이점
- 내부 노드에는 키만 저장하고, 실제 데이터는 리프 노드에만 저장한다.
- 루트와 중간 노드들은 데이터를 찾기 위한 포인터 역할만 한다.
- 모든 리프 노드가 연결 리스트로 이어져 있다.
	[10 | 20 | 30]         ← 내부 노드 (키만 존재)
      /    |    |    \
   [1~9] [10~19] [20~29] [30~]  ← 리프 노드 (데이터 저장)
     →      →       →      →    ← 연결 리스트로 연결
덕분에 범위 탐색 시 리프 노드의 연결 리스트를 따라가기만 하면 되어 훨씬 효율적이다. MySQL InnoDB가 B+Tree를 채택한 이유가 바로 이 때문이다.
시간 복잡도
(1) 탐색 / 삽입 / 삭제: O(log n) (B-Tree 와 기본 성능은 동일)
(2) 범위 탐색: O(log n + k) (k 는 범위 내 데이터 수)
루트에서 리프까지 가는 시간(log n) + 연결 리스트를 따라가는 시간(k)만 소요되어 B-Tree보다 훨씬 빠르다.
단점
(1) 공간 낭비 : B-Tree와 마찬가지로 노드가 완전히 차지 않은 경우 빈 공간이 생길 수 있으며, 중간 노드에 키를 중복해서 저장(가이드 역할)하기 때문에 추가적인 메모리가 필요하다.
(2) 단일 탐색의 오버헤드: B-Tree는 루트나 중간 노드에서 데이터를 바로 찾을 수도 있지만, B+Tree는 무조건 최하단 리프 노드까지 내려가야 데이터를 얻을 수 있다.
예를들어 데이터가 어디에 들어있느냐의 차이로 이해하면 쉽다.
쉽게 비유하자면 B-Tree는 각 층마다 물건이 놓여있는 창고이고, B+Tree는 물건은 무조건 1층에만 있고 윗층은 안내판만 있는 백화점이다.
B-Tree는 루트나 중간 노드에 키 & 데이터가 같이 들어있어 만약 찾는 데이터가 운좋게 루트 노드에 있다면 더 아래로 내려갈 필요없이
그 자리에서 바로 데이터를 꺼내 반환한다. 즉 탐색 종료이다.
하지만 B+Tree는 무조건 1층 리프 노드에 데이터가 있고 루트&중간 노드에는 키만 있기때문에 내가 찾는 데이터의 키가 루트 노드에서
보일지라도 이건 단순이 이 데이터는 왼쪽 아래로 내려가라~라는 키(안내판)일뿐이다.
따라서 실제 데이터를 탐색하려면 무조건 밑바닥인 리프노드까지 가야만 한다.
때문에 단일 탐색 관점에서는 B-Tree가 운 좋으면 1~2번 만에 끝날 일을 B+Tree는 항상 트리의 높이만큼 끝까지 내려가야 하니 오버헤드인 것이다.
하지만 왜 B+Tree를 더 많이 쓸까?
트리의 높이는 한번에 얼마나 많은 자식으로 분기 할수 있느냐에 반비례 하다.
1. B+Tree는 중간 노드에서 무거운 데이터들을 모두 빼버리니
2. 그 빈 공간에 자식으로 가는 Key들을 더 많이 채울수 있고
3. 한번에 수백 개씩 갈래가 나뉘니, 트리가 옆으로 넓게 퍼지고 위아래 높이는 낮아지는 효과가 나타난다.
그래서 단일 탐색에서는 조금 손해 보더라도 대부분의 경우 B+Tree가 리프까지 가는 속도가 B-Tree가 중간에서 우연히 찾는 속도보다 빨라지게 된다.
B*Tree
B*Tree는 B+Tree의 노드 분할(Split) 과정에서 발생하는 공간 낭비와 연산 비용을 줄이기 위해 등장했다.
핵심은 최대한 버티다가 쪼개는 것이다.
1. B+Tree와의 핵심 차이점
(1) 더 엄격한 채움 조건: B+Tree는 노드의 1/2(50%)만 차도 유지되지만, B*Tree는 노드의 2/3(66%) 이상이 반드시 채워져 있어야 한다.
(2) 분할(Split) 대신 재배치(Redistribution): 노드가 꽉 차면 즉시 2개로 쪼개는 대신, 옆에 있는 형제 노드에 빈 공간이 있는지 먼저 확인한다. 남는 공간이 있다면 데이터를 옆으로 밀어 넣어 분할 시점을 최대한 뒤로 미룬다.
분할(Split)이 발생하는 이유
노드 하나가 담을 수 있는 최대 크기(m)가 정해져 있는데, 새로운 데이터를 또 넣으려고 하면 상자가 터지기 일보 직전이 된다.
이때 트리는 균형을 유지하기 위해 상자를 두 개로 쪼개는 결단을 내린다.
(1) 데이터 가득 참: 10칸짜리 노드에 10개가 다 찼는데 1개가 더 들어옴.
(2) 분할 발생: 이 노드를 반으로 쪼개서 5개, 5개씩 나누고, 중간에 있던 값 하나를 부모 노드 위로 올려보냄.
(3) 결과: 상자는 2개가 되고, 부모 노드 입장에서는 자식이 하나 더 늘어난다.
왜 B*Tree에서 "분할을 덜 한다"고 할까?
분할을 하면 새 상자(노드)를 만들어야 하니 메모리(공간)가 더 필요하다.
그래서 B*Tree는 "옆 친구한테 물어보기" 전략을 쓴다.
(1) B-Tree / B+Tree: "내 상자 꽉 찼어! 무조건 반으로 쪼갤래! (분할)"
=> 결과: 상자가 갑자기 2개가 되고, 각각 50%씩만 차게 됨 (공간 낭비 발생).
(2) B*Tree: "잠깐! 옆 상자(형제 노드)야, 너 자리 남니? 남으면 내 것 좀 가져가! (재배치)"
=> 결과: 옆 상자로 넘겨주고 분할을 안 함. 둘 다 꽉 찼을 때만 상자를 3개로 쪼개서 각각 67% 이상 채워지게 만듦.
2. 장점 (Efficiency)
(1) 높은 공간 활용도: 노드를 더 꽉꽉 채워서 사용하므로 메모리 낭비가 적다.
(2) 트리 높이의 안정성: 노드가 잘 쪼개지지 않으므로 트리의 전체 높이가 더 낮게 유지될 확률이 높다.
(3) 연산 비용 감소: 노드 분할은 트리 구조를 재조정해야 하는 무거운 작업이다. B*Tree는 이 발생 빈도를 획기적으로 낮춰 실질적인 삽입/삭제 성능을 높였다.
3. 시간 복잡도
탐색 / 삽입 / 삭제: O(log n) 이론적 수치는 동일하지만, 노드 재배치 덕분에 구조 변경 횟수가 적어 실제 시스템 운영 시 효율이 더 좋다.
B-Tree 계열 세 자료구조를 정리하면 결국 하나의 흐름이다.
- m원 탐색 트리의 균형 문제 → B-Tree로 해결
- B-Tree의 범위 탐색 문제 → B+Tree로 해결
- B+Tree의 공간 낭비 문제 → B*Tree로 해결
각 자료구조는 이전 구조의 단점을 개선하기 위해 등장했고, 그 끝에 MySQL InnoDB가 B+Tree를 채택한 이유도 자연스럽게 이해된다.
Tree는 Graph의 한 종류다. B-Tree 계열을 깊게 파고들었으니, 다음에는 Tree를 포함하는 더 큰 분류인 Graph 자료구조를 정리할 예정이다.
참고
'공부 > 자료구조' 카테고리의 다른 글
| (5) Graph (0) | 2026.03.09 |
|---|---|
| (4) Tree (1) | 2026.03.05 |
| (3) Stack, Queue (1) | 2026.03.02 |
| (2) Array, Linked List (0) | 2026.02.28 |
| (1) 자료 구조란? (0) | 2026.02.26 |